


顛覆圍棋AI常識的「AlphaGo」
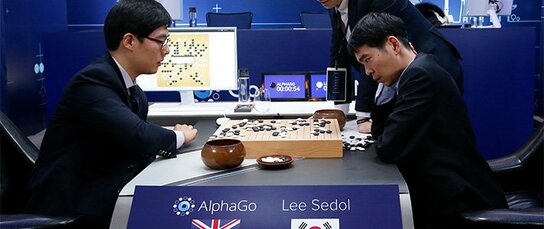
圍棋界也發生了一件與神經網路翻譯一樣的大事件。正如開篇提到的,2016年3月,DeepMind公司開發的「AlphaGo」成功擊敗了職業9段棋士。而這個會下圍棋的AI也是用完全不同於以往的方法進行開發的。
「AlphaGo」具有判斷局勢的Value-Network和判斷套路的Policy-Network的雙層深層神經網路。然後就是不斷讓它學習過去的棋譜,與自己對戰,以此磨練棋藝。這種方法叫做深度強化學習,是現在的主流方法之一。
在此之前的圍棋AI是通過程式設計寫入圍棋規則和定式,在很大程度上需要依賴人腦思考,下達指令,才能下棋。圍棋AI的程式師會研究人類棋士如何打敗對手,並結合單純的機器學習來創造一個圍棋AI高手,然而這種嘗試並沒有誕生出能夠與職業棋士分庭抗禮的AI。
籍籍無名的DeepMind橫空出世,用AI打敗了人類棋士。受此刺激,DWANGO、百度等日本和中國的科技巨頭以及業餘程式師都紛紛投身AI圍棋大賽。另一方面,電氣通信大學從2007年起一直每年舉辦的「UEC杯世界電腦圍棋賽」,受「AlphaGo」戰績的影響,於2017年3月在第10屆大賽上宣布停辦。
DeepMind此後也不斷開發和發表新技術,一直引領著世界技術發展。日本國內Yahoo、DWANGO或Preferred Networks等新興勢力也開始投入到Deep Learning的研究中,此外以豐田、FANUC為首的巨頭企業也不斷加大投資力度,可惜至今還沒有什麼值得一提的成果問世。
(2017年3月20日)
標題圖片:2016年3月,美國Google旗下的DeepMind公司開發的「AlphaGo」以4勝1負的成績戰勝了韓國棋手李世石(AP/Aflo)

 其他語言閱讀